VoxCPM2とは?日本語の実力とローカル導入手順を解説
 AIエージェントナビ編集部

AIによる音声合成を試したいものの、どのモデルを選べば良いか迷っていませんか。本記事では、商用利用が無料で日本語にも対応したオープンソース音声モデル「VoxCPM2」の概要から、ブラウザで試す手順、PCへの導入方法までを解説します。
この記事に対する編集部の見解
- 公式ベンチマークの日本語成績は、声の再現度(SIM)が比較5モデル中1位・読みの正確さ(WER)は4位。声は似るが読み間違いは残る
- 読み間違いが許されないナレーション用途は人の校正が前提。声の一貫性が価値になる用途では強い
- クラウド型は従量課金・VoxCPM2は自社GPUの固定費。利用量と情報管理の要否で選ぶ
VoxCPM2とは?48kHz・30言語で商用無料
VoxCPM2は2026年4月にリリースされた最新の音声生成モデルです。その基本性能について、公式READMEでは以下のように定義されています。
a 2B parameter model trained on over 2 million hours of multilingual speech data(200万時間を超える多言語の音声データで学習された、2B=20億パラメータのモデル)
多言語対応において突出した能力を持ち、日本語を含む30の言語で、極めて自然な発話を生成することが可能です。
4つの生成モード
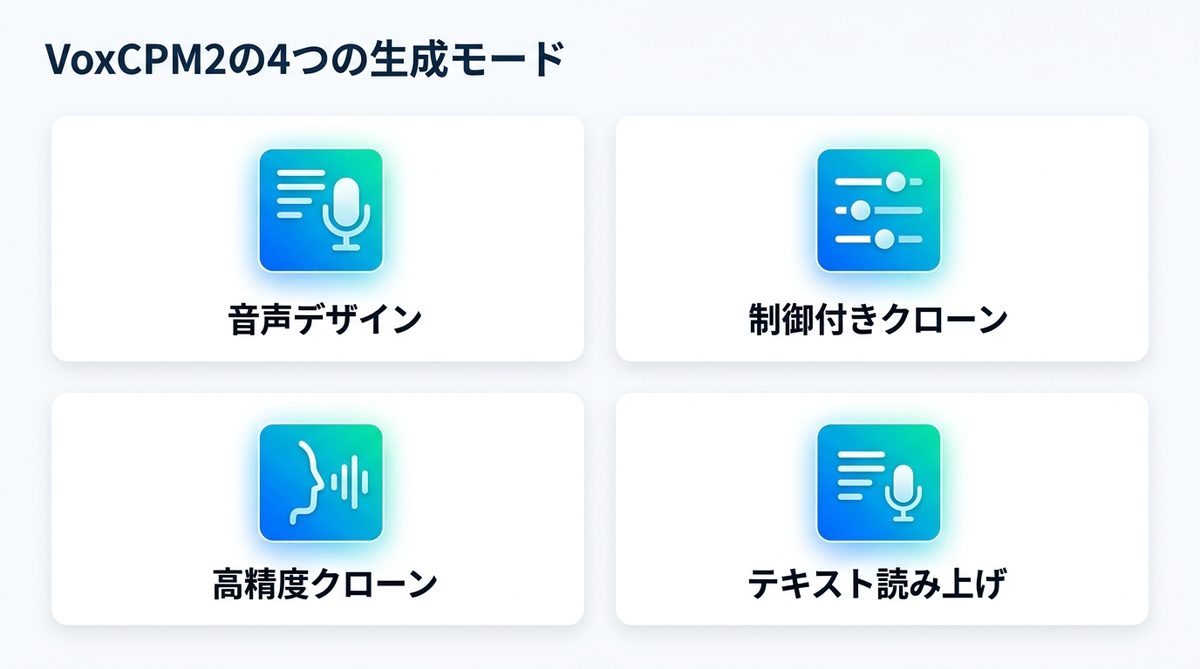
VoxCPM2には、用途に応じた4つの生成モードが用意されています。
- Voice Design(音声デザイン):テキストによる指示(例:「落ち着いた女性の声で」など)から、参照音声なしでゼロから自然な音声を生成します。
- Controllable Voice Cloning(制御付きボイスクローン):数秒の参照音声とスタイル指示を組み合わせて、特定の人物の声を維持したまま感情表現などを制御します。
- Ultimate Cloning(高精度クローン):参照音声と、それに対応する書き起こしテキストをセットで入力することで、声質だけでなく喋り方の癖まで極めて高い精度で複製します。
- Text-to-Speech(TTS):標準的なテキスト読み上げ機能です。
旧版との違い
VoxCPM2は、旧バージョンと比較してサンプリングレートが48kHzに引き上げられ、オーディオ品質が飛躍的に向上しました。
| 項目 | VoxCPM2 | VoxCPM1.5 | VoxCPM-0.5B |
|---|---|---|---|
| パラメータ | 2B | 0.6B | 0.5B |
| 音声サンプリングレート | 48kHz(※入力は16kHz) | 44.1kHz | 16kHz |
| 対応言語数 | 30 | 2 | 2 |
| Voice Design | あり | なし | なし |
| 制御付きボイスクローン | あり | なし | なし |
| 必要VRAM | 約8GB | 約6GB | 約5GB |
| RTF(RTX 4090) | 約0.30 | 約0.15 | 約0.17 |
Apache-2.0の商用利用
VoxCPM2の最大の魅力の一つは、そのライセンス形態にあります。公式には次のように明記されています。
Weights and code released under the Apache-2.0 license, free for commercial use(重みとコードはApache-2.0ライセンスで公開されており、商用利用は無料です)
これにより、企業が自社のプロダクトやサービスにVoxCPM2を組み込み、商用として提供することが無償で認められています。ただし、他人の声を無断でクローンするなどの悪用を防ぐため、利用時には倫理的なガイドラインの遵守と安全性の評価を行うことが強く推奨されています。
インストールの前にブラウザで試聴
自分のPCに環境を構築するには相応の手間がかかります。まずはブラウザ上でデモを触り、VoxCPM2の「声の質」を確認しましょう。
公式デモの活用
開発元のOpenBMBは、Hugging Face Spaces上で対話的なデモを公開しています。ここでは、テキスト入力による音声生成や、短い音声ファイルをアップロードしてのボイスクローンを、ブラウザだけで体験できます。特に日本語のイントネーションが自分の用途(ナレーション、対話エージェントなど)に耐えうるかを判断するのに最適です。
ローカル導入の必要性
デモ環境はあくまで共有リソースで動作しているため、生成の待ち時間が発生します。また、プライベートなデータを用いた大量の音声生成や、アプリケーションとのリアルタイム連携、インターネット接続のないオフライン環境での利用を検討している場合は、ローカル環境への導入が必須となります。
導入の判断基準
VoxCPM2は、後述するように「声の似せ方」においては世界トップクラスの性能を誇りますが、日本語の「読み間違い」はゼロではありません。デモで複数の文章を試してみて、許容できる範囲であるか、または後述する「読み間違いを減らす工夫」で対応できそうかを確認してください。
PCへの最短導入手順
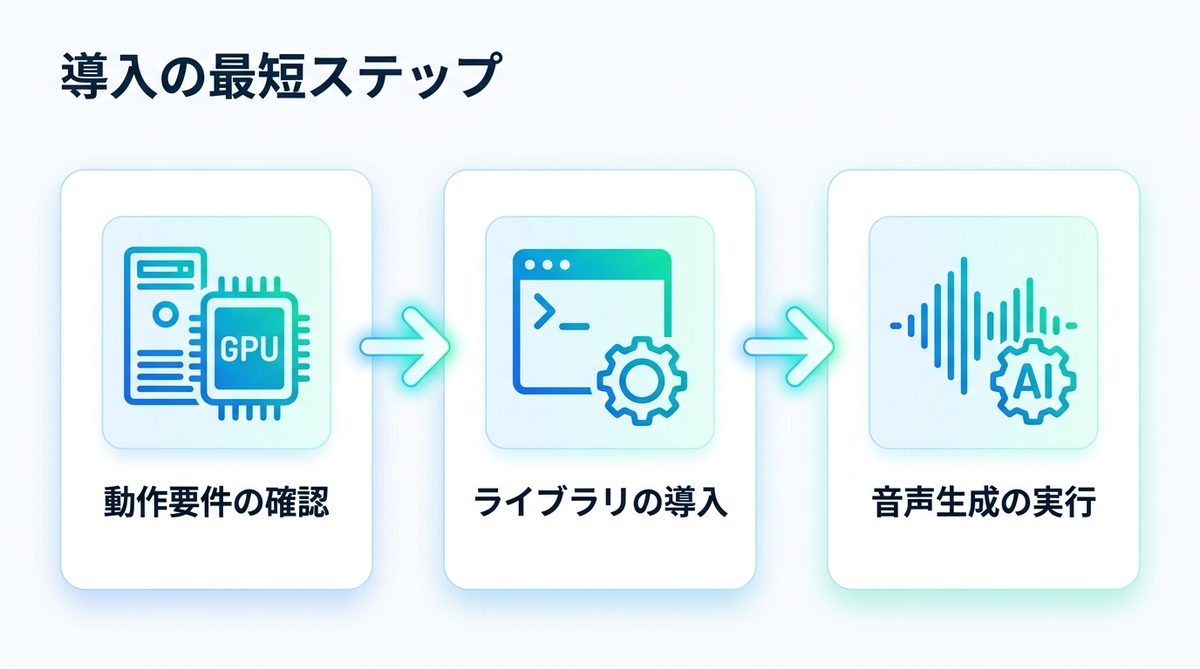
ローカル環境への導入は、Pythonがインストールされている環境であれば非常にスムーズです。
動作要件
VoxCPM2(2Bモデル)を快適に動作させるには、約8GBのVRAMを搭載したGPUが推奨されます。NVIDIA製GPU(CUDA)はもちろんのこと、Apple Silicon(M1/M2/M3/M4)を搭載したMacでも、Metalを利用した高速化によって動作が可能です。
pip導入手順
ライブラリのインストールは、以下のコマンドを実行するだけで完了します。
pip install voxcpm
これにより、推論に必要な依存ライブラリとCLIツールが一括でセットアップされます。
CLIでの生成
導入後、すぐにコマンドラインから音声生成を試すことができます。以下に主要な実行例を挙げます。
1. 音声デザイン(スタイル指定付き)
特定の感情やスタイルを指定して音声を生成します。
voxcpm design --text "こんにちは、今日はとても良い天気ですね。" --control "Young female voice, warm and gentle, slightly smiling" --seed 42 --output out.wav
2. ボイスクローン
参照音声を元に、その人の声で喋らせます。
voxcpm clone --text "お疲れ様です。本日の進捗を報告します。" --reference-audio path/to/voice.wav --output out.wav
3. バッチ処理
複数のテキストをまとめて処理する場合は、テキストファイルを読み込ませるバッチモードが便利です。
voxcpm batch --input examples/input.txt --output-dir outs
日本語の実力とベンチマーク
VoxCPM2が他の主要モデルと比較してどの程度の立ち位置にいるのか、公式が公開している日本語のベンチマークデータ(多言語テストセット)を確認しましょう。
| モデル | WER 読み間違いの少なさ(小さいほど良い) | SIM 声の似せ方(大きいほど良い) |
|---|---|---|
| VoxCPM2 | 4.628 | 82.8 |
| Minimax | 3.519 | 77.6 |
| ElevenLabs | 10.646 | 73.8 |
| Qwen3-TTS | 3.823 | 78.8 |
| FishAudio S2 | 2.760 | 79.6 |
ベンチマーク結果
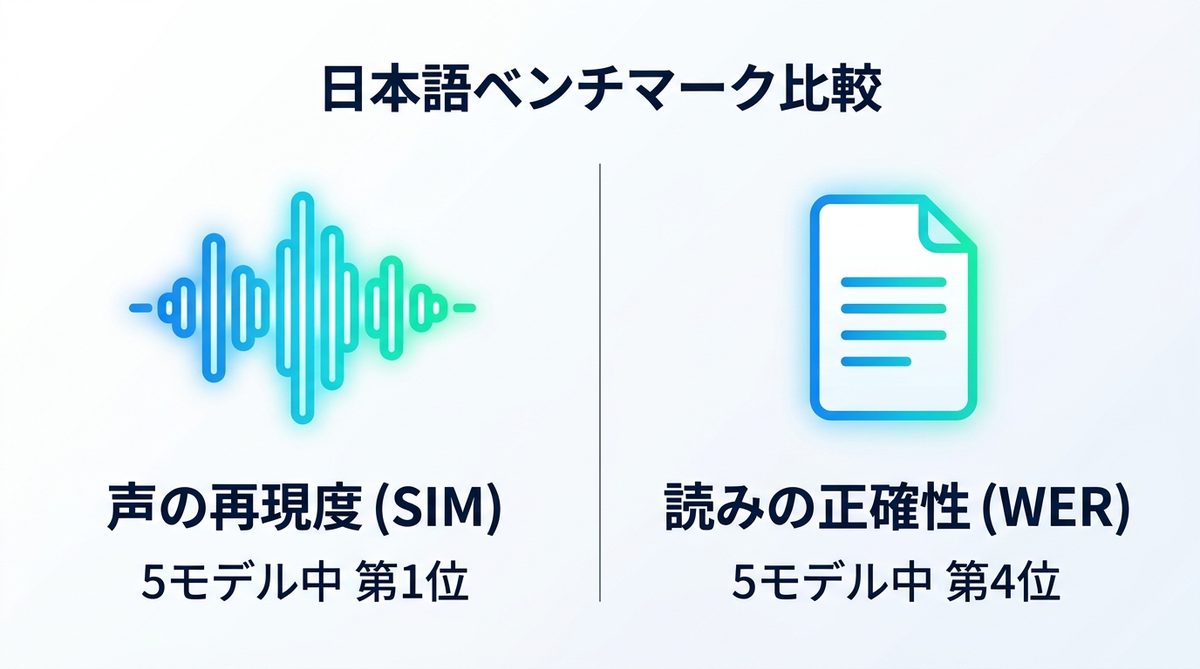
この数字から明確な傾向が見て取れます。VoxCPM2は、参照音声の特徴をどれだけ捉えているかを示す「SIM」指標において、82.8という最高値を記録しました。これは、特定のキャラクターや人物の声を再現する用途において、現状で最も優れた選択肢の一つであることを意味します。
一方で、文字の読み間違いの少なさを示す「WER」は4.628となっており、5モデル中4位(下から2番目)の結果となりました。FishAudioやMinimaxには一歩及びません。とはいえ、世界的なシェアを持つElevenLabs(10.646)と比較すれば、日本語の読み上げ精度は十分に高い水準にあります。
数値の読み方
ベンチマーク結果はあくまで開発元による特定のデータセットでの測定値です。実際の利用シーンでは、文章の難易度や参照音声の質によって体感的な精度は変わります。「声の再現度は非常に高いが、読みについては完璧を求めず、適宜調整が必要なモデル」と捉えるのが現実的です。
読み間違い対策
日本語特有の難読漢字や、同音異義語の読み間違いを防ぐには、以下のような工夫が有効です。
- 難解な漢字はひらがなやカタカナで記述する。
- 句読点(、。)を適切に入れ、文脈の区切りをモデルに認識させる。
- 「?」などを用いて疑問文のイントネーションを誘導する。
クラウド型との比較と選び方
関連記事:ElevenLabsとは?ビジネス導入のメリットと商用利用ルール
コスト構造の違い
ElevenLabsのようなSaaS型サービスは、月額費用や生成文字数に応じた従量課金が発生します。これに対し、VoxCPM2はApache-2.0ライセンスのためソフトウェア費用は無料です。自社でGPUサーバーを用意する初期投資や電気代はかかりますが、24時間稼働させるような大量生成のケースでは、VoxCPM2の方が圧倒的に低コストになる場合があります。
用途別の適性
- VoxCPM2が向いている用途:機密情報を扱うため外部APIに音声を送りたくないケース、特定の声を極めて高い精度で再現したいケース、ゲームやアプリに組み込んでオフライン動作させたいケース。
- 向かない用途:インフラの管理を一切したくないケース、常にメンテナンスされた最新の多種多様な声質をカタログから選びたいケース。
業務システムへの組み込み
ComfyUIへの統合
VoxCPM2は、画像生成AIで広く使われているComfyUIのカスタムノードとしても提供されています。これにより、キャラクター画像の生成と同時に、そのキャラクターに最適な声でセリフを喋らせるといった、一貫した制作パイプラインを構築することが可能です。
ストリーミングと高速化
対話型のシステムでは、生成の完了を待たずに音声を流し始める「ストリーミング」が要ります。VoxCPM2では generate_streaming メソッドで実現できます。
高速化の手段も用意されています。llama.cpp-omni を Apple M4 Pro / Metal 環境で動作させた場合、RTF(Real Time Factor)は約1.76という数値を記録しています。RTFは「音声の長さに対して処理にどれだけ時間がかかったか」を表す指標で、1.0を下回れば実時間より速いことを意味します。つまり1.76は、1秒の音声を作るのに約1.76秒かかる=実時間より遅い計算になります。GPUを積まないMacでも動く点に価値がありますが、リアルタイム対話のような即応性が要る用途には向きません。応答速度を優先するなら、NVIDIA環境で「Nano-vLLM-VoxCPM」や「vLLM-Omni」を使う構成(RTX 4090でRTF約0.13)を検討してください。
関連記事:Voxtralとは?Claude Codeと連携し「感情を持つAIエージェント」を構築する
関連記事:Foundry Localとは?Microsoftが描く「ローカルAIエージェント」の全体像
よくある質問
商用利用の無料範囲
はい、Apache-2.0ライセンスに基づき、商用サービスへの組み込みを含め無料で利用可能です。
他人の声のクローン
技術的には可能ですが、法的な権利関係(肖像権、パブリシティ権など)や倫理的なリスクが伴います。必ず本人の許諾を得た音声や、権利関係がクリアな音声データを使用してください。
必要なPCスペック
VRAM 8GB以上のGPUを推奨します。最新のMacBook(M2/M3/M4)であれば、メモリ16GB以上のモデルで快適に動作します。
日本語の読み間違い
API経由であれば、入力テキストを事前に正規化(漢字をひらがなに変換するなど)する処理を挟むことで大幅に改善可能です。
まとめ
- VoxCPM2は、入力16kHz・出力48kHzという高効率かつ高品質な商用無料モデルです。
- 公式デモで音質を確認し、「声の再現度(SIM値)」の高さが自分の用途に合うか確かめましょう。
- ローカル導入は
pip install voxcpmで完結し、CLIから詳細なスタイル指定やクローンが可能です。 - 応答速度が要る用途はNVIDIA環境(Nano-vLLMでRTF約0.13)を前提にしてください。Macで動くllama.cpp-omniはRTF約1.76=実時間より遅く、リアルタイム対話には向きません。
まずは公式のデモページで、自分が使う文章を読ませてみてください。声の再現度と読み間違いの両方を、自分の用途で確かめるのが一番の近道です。
AIエージェントナビ編集部の見解
AIエージェントナビでは、各記事のテーマについて編集長が「実際どうなの?」という素朴な疑問を「Nav」と名付けたAIエージェントにぶつけています。エンジニアではなく、経営者・ビジネス視点からの率直な見解をお届けします。
編集長の率直な感想
編集長
Nav
編集長
Nav
編集長
Nav
編集部のまとめ
- 公式ベンチマークの日本語成績は、声の再現度(SIM)が比較5モデル中1位・読みの正確さ(WER)は4位。声は似るが読み間違いは残る
- 読み間違いが許されないナレーション用途は人の校正が前提。声の一貫性が価値になる用途では強い
- クラウド型は従量課金・VoxCPM2は自社GPUの固定費。利用量と情報管理の要否で選ぶ