AI仕様駆動開発の実践|Claude CodeとCodexで進めた1年半
 AIエージェントナビ編集部
寄稿本記事は、AIの受託開発や伴走支援を行う株式会社フィールフロウ CTOの岡崎太氏によるご寄稿です。
Claude CodeやCodexに実装を任せるほど、書かれるコードは増えていきます。すると今度は、人のレビューが追いつかなくなります。かといって、AIのレビューをどこまで信じてよいのかも分かりにくいところです。
当社は2025年4月の設立直後からClaude Codeを使って開発を続けてきました。開発チームは今、非エンジニア1名を含む5名です。2025年12月からは、支援先の1社でも同じ進め方の導入を手伝っています。本記事では、この2つの経験をもとに、仕様に何を書くか、レビューをAIに任せた経過と数字、うまくいかなかったこと、導入の手順5つをお伝えします。
AI仕様駆動開発とは
AI仕様駆動開発は、AIに渡す前提を、その場のプロンプトではなくリポジトリの文書として置いておき、AIエージェントに開発を任せる進め方です。この章では、プロンプトだけで任せる場合との違いと、文書の中身、始め方をお伝えします。
プロンプトだけで任せる場合との違い
プロンプトはその場限りです。そのため毎回説明し直す必要があり、説明が抜けたところはAIが推測で埋めてしまいます。
仕様がリポジトリにあれば、AIは毎回同じ前提を読みにいけます。決まっていないことも「未決」として見えるので、勝手な思い込みで作られることが減ります。
基本の7文書と置き場所
当社では、仕様をリポジトリの docs/ の下に置いています。基本は次の7つの文書で、開発が進むにつれて増えていきます。
| 文書 | 書くこと |
|---|---|
| MASTER.md | 入口と目次。合意したこと、まだ決まっていないこと、関連するIssue(課題票)へのリンク |
| 01-context/PROJECT.md | 目的、誰のためのものか、成功の基準、やらないこと |
| 02-design/DOMAIN.md | 業務のルール、用語、具体例と例外 |
| 02-design/ARCHITECTURE.md | 検討した選択肢、技術の選定、セキュリティ |
| 03-implementation/PATTERNS.md | 採用した書き方のパターンと、その理由 |
| 04-quality/TESTING.md | 完成の条件、リスク、確認の方法 |
| 05-operations/DEPLOYMENT.md | 公開の手順、監視、障害からの復旧 |
出典:株式会社フィールフロウ(公開リポジトリ feel-flow/ai-spec-driven-development のひな形)
7文書のひな形は、当社が公開しているリポジトリに置いています。下の図は、その中で7文書がどこにあるかを示したものです。
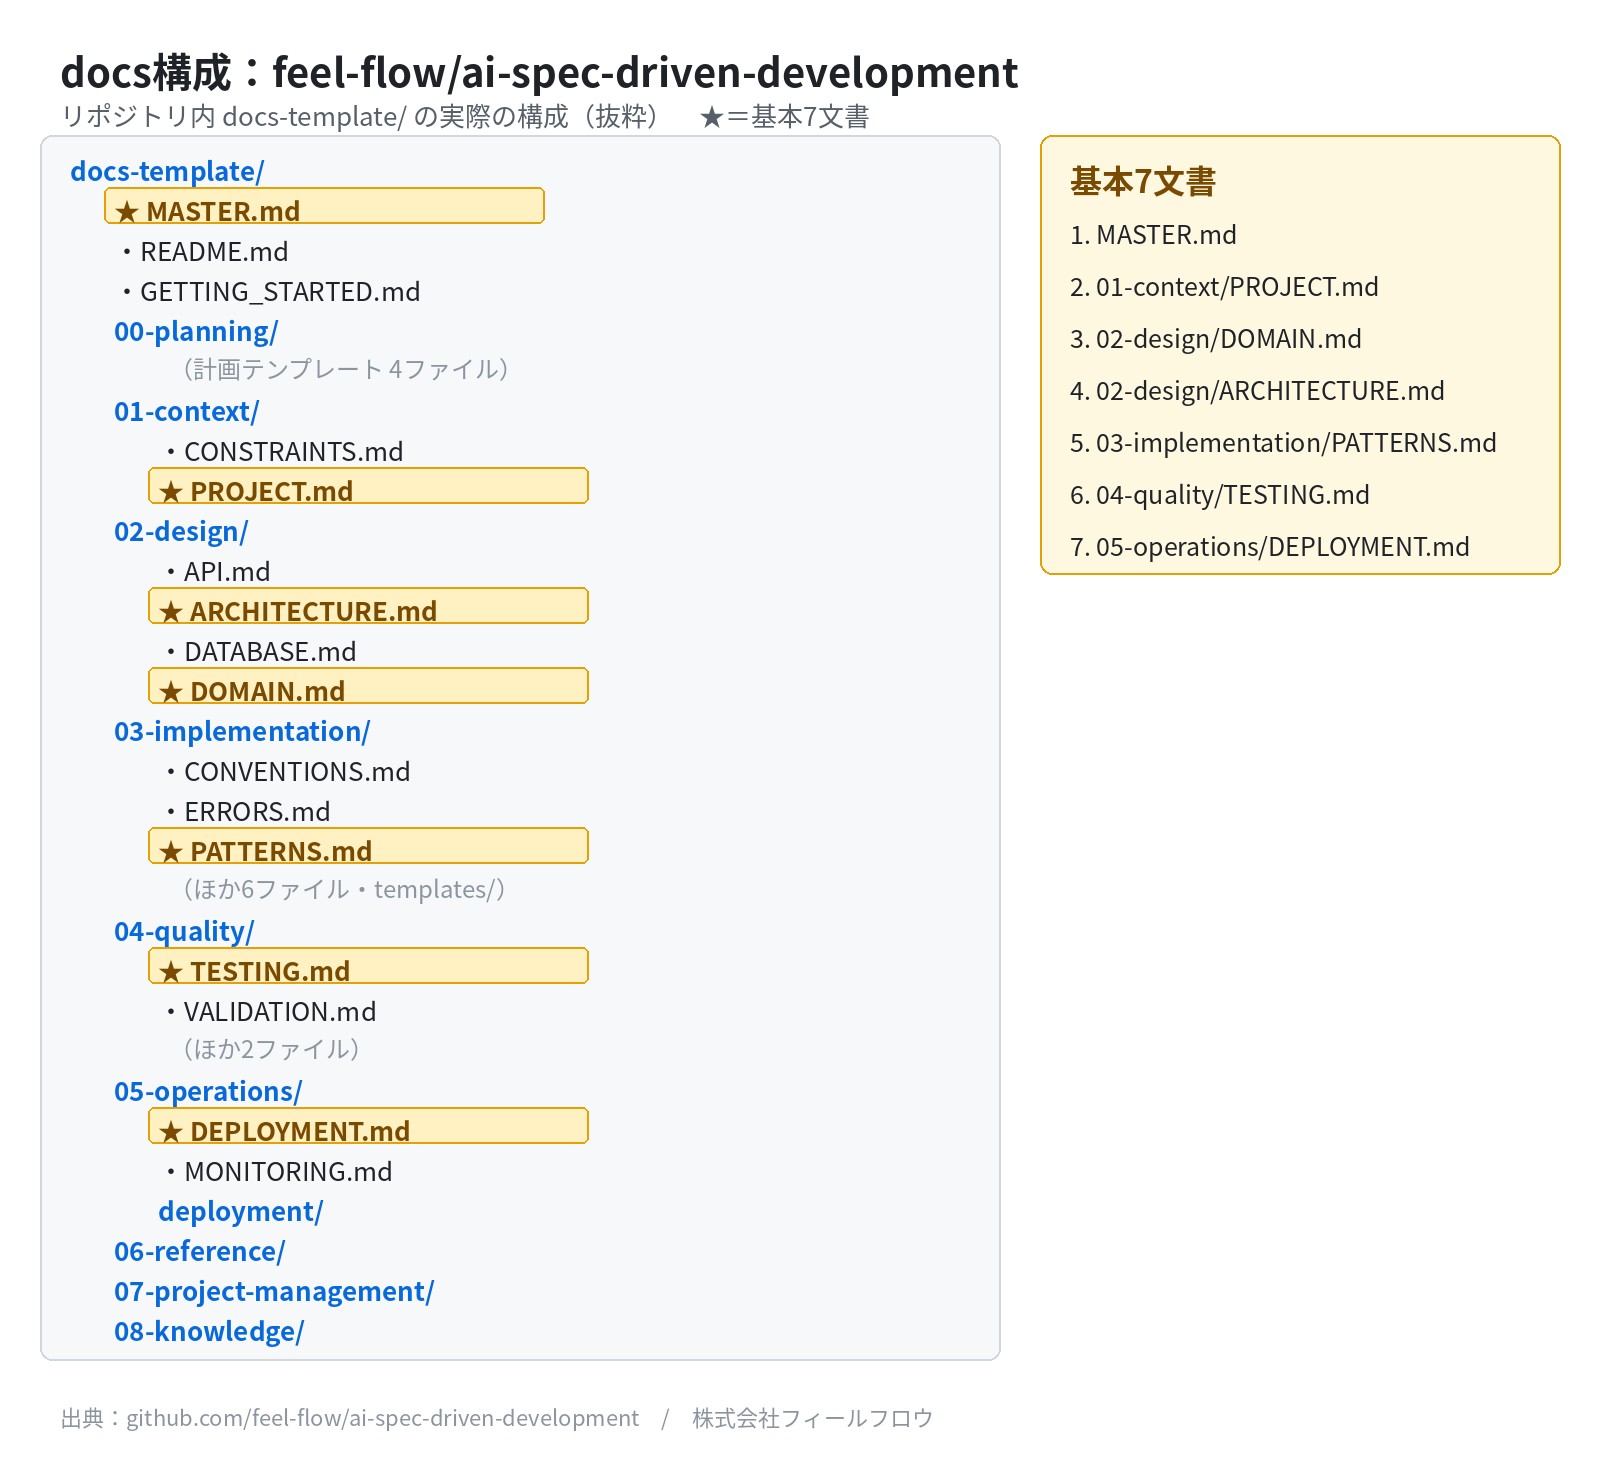
▲ 当社の公開リポジトリ(feel-flow/ai-spec-driven-development)にある、基本7文書のひな形の構成(株式会社フィールフロウご提供)
最初は短いMASTER.md 1枚から
7つの文書を、最初から全部そろえる必要はありません。今の当社の考え方では、まず短いMASTER.mdから始めて、必要になったら分けていきます。最初から完璧な仕様をそろえようとすると、そこで止まってしまうからです。
決まっていないことは「未決」と残す
仕様は、AIと人が対話しながら作ります。目的、制約、おすすめの案についてAIと人が合意し、まだ決まっていないことはAIに勝手に埋めさせません。未決のものは「未決」として残します。
もう1つ決めているのは、人から返事がないことを「承認」とは扱わないことです。あわせて、工程ごとに次へ進むための条件も決めています。
コードレビューの自動化
AIに実装を任せるようになって、当社で一番詰まったのはコードレビューでした。この章では、レビューをAIに任せるまでの経過と、その後の数字をお伝えします。
実装を任せたら、レビューが追いつかなくなった
AIに実装を任せるようになると、書かれるコードの量に人のレビューが追いつかなくなり、レビューが一番のボトルネック(詰まり)になりました。そこで、レビューそのものをAIに任せることにしました。
2つ目のAIをレビュアーにする
手元では、2つ以上のLLM(大規模言語モデル)で同じ変更を見る「マルチレビュー」を回しています。メインがClaudeなら、2人目のレビュアーはCodexやGrokです。同じモデルだけで書いてレビューすると見方が偏るため、別のLLMを2人目に置いて、違う視点の指摘が入るようにしています。
GitHub上では、ClaudeとCodexがプルリクエスト(変更の取り込み依頼)をレビューします。レビューのボットは一度に入れたのではなく、Copilot(2025年7月)、CodeRabbit(2025年11月)、Claude(2026年3月)、Codex(2026年5月下旬)と段階的に増やしました。
今は、プルリクエストごとのレビューに人は入っていません。人が読むのは、振り返り(retrospective)のスキルが出す要約だけです。導入の前と後で流れがどう変わったかを、下の図にまとめました。
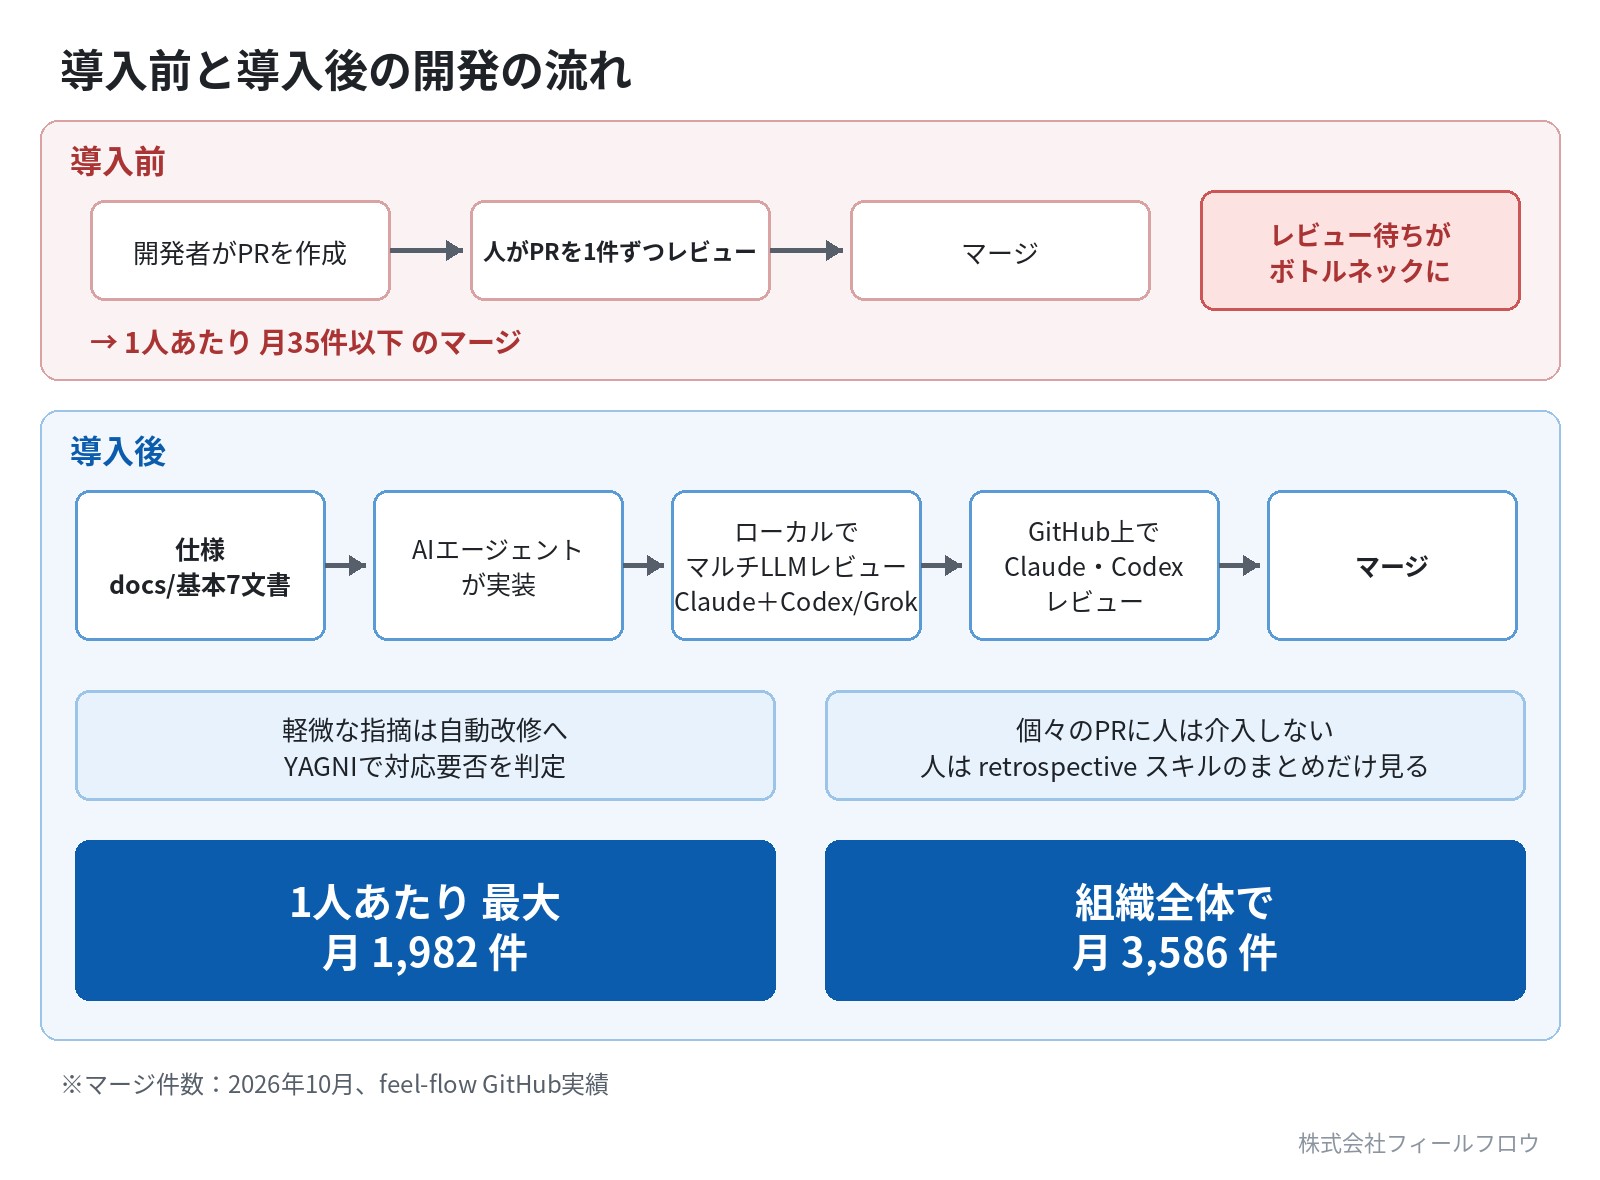
▲ 当社開発チームの導入前後の開発の流れ。上段の35件は2025年9月までの1人あたりの値、下段は2026年10月のマージ済みプルリクエスト数で、左は最も多いメンバーの値です。上段と下段は同じ物差しで比べた数字ではありません(株式会社フィールフロウご提供)
マージ件数の変化
レビューをAIに任せたことで、マージ(取り込み)できるプルリクエストの数は大きく増えました。当社のGitHubの実データで、前と後を比べます。
| 2025年9月まで | 2026年10月 | |
|---|---|---|
| 1人あたり(月) | 35件以下 | 最も多いメンバーで1,982件 |
| 組織全体(月) | 100件未満 | 3,586件 |
出典:株式会社フィールフロウ(GitHubのfeel-flow organizationにおけるマージ済みプルリクエスト数)
2025年9月までは、AIで開発していても月100件には届いていませんでした。組織全体では2026年7月に初めて月3,000件を超え(3,065件)、2025年4月から2026年10月までの合計は23,676件です。
なお、2026年10月の1,982件は最も多いメンバーの値で、平均ではありません。また、これらは設立から1年半の、今は5名のチームの数字です。条件が違えば同じ数字にはならず、件数は1件の大きさでも変わります。
支援先で起きた考え方の変化
自社で効果を確かめた仕組みは、支援先にも広げています。この章では、支援先のB社さまで、レビューに対する考え方が変わるまでをお伝えします。
自社で試してから、支援先へ広げる
B社さまは、企業間の情報共有や業務連携を支援する自社サービスを運営する、業界大手の会社です。当社は2025年12月から、AI仕様駆動開発の伴走支援をしています。
当社からは2名が入り、B社さまの開発メンバーは1名から始まって、少しずつ増えて今は約10名です。進め方は、まず当社で試して効果を確かめ、それをB社さまに展開する形です。AIレビューの仕組みも、この順で広げました。
「自分が100点なら、AIは70点」
展開を始めたころ、エンジニアの中には、自分のレビューのほうが確かだと考える方もいました。ある方は「自分が100点なら、AIは70点」とおっしゃっていました。
毎月のKPTで変わったこと
B社さまでは、開発メンバーで毎月、KPT(Keep/Problem/Try=続けること・問題・次に試すこと)で振り返りを行いました。その中で見えてきたのは、AIへの指示を書くのは結局人間だということです。だから大事なのは、いろいろな視点を持ったレビュアーを作り、それを継続的に見て、更新し続けることです。
こうして、AIを「信じる」のではなく、AIを「使いこなす」方法を覚える、という考え方に変わっていきました。定着までには約3か月かかりました。今は、人のレビューをできるだけ減らす方向で進んでいます。
レビューが終わらなくなった失敗
うまくいかなかった例もあります。モデルが賢くなったことで、かえってレビューが終わらなくなった経験です。
賢いモデルが、細かい指摘まで「必ず直す」と判断した
Opus 4.8のころから、モデルの推論力が上がりました。ところが同じワークフロー(作業の流れ)のままだと、レビュアーのAIが、ほとんど害のない指摘や、まれにしか起きず再実行で解決するような問題まで「必ず直すべき」と判断するようになりました。
その結果、レビューと修正のループがいつまでも終わらなくなりました。ワークフローを自動で改善する仕組みも、改善どころか、かえって悪くしていく方向に働いてしまいました。
原因は、何を捨ててよいかを渡していなかったこと
モデルは賢くなっても、ワークフローは以前のままでした。原因は、何が重要で、何は捨ててよいかという判断基準を、AIに渡していなかったことです。
YAGNIを判断基準として渡す
そこで、レビューの指摘に対応するかどうかを決める基準として、YAGNI(You Aren't Gonna Need It=今必要でないものは作らない)を取り入れました。何が大事で、何は落としてよいかを、AIに伝えるようにしています。
その後は、品質を保ったまま、とても速いスピードで開発できていると感じています。
AIに任せる工程と人が決める工程
開発の工程のうち、当社がAIに任せている工程と、人が判断し続けている工程を表にまとめます。
| AIに任せている工程 | 人が判断し続けている工程 |
|---|---|
| 実装 | 目的を決めて、仕様に合意する |
| テスト | 振り返りの要約を読む |
| レビュー(複数のLLMによるマルチレビュー) | 何が重要かを決める(YAGNIに沿った判断の方針) |
| 振り返りで見つかった軽微な修正 | モデルを評価する |
実装・テスト・レビュー・軽微な修正はAIに任せる
目的と判断基準が仕様として書かれていれば、これらの工程はAIのほうが速く、量もこなせます。毎日の振り返りのスキルで出てきた軽微な対応は、自動で直す仕組み(自動改修ループ)に回し始めています。
最近は、Claude DesktopやCodexアプリの進化に加え、OpenAIのdotsのように仮想環境を用意してくれるAIのボットが出てきました。その中で開発を完全に自動で回せるようになり、品質管理もスピードも一段上がってきたと感じています。
目的・判断の方針・モデルの評価は人が持つ
表の右側の工程は、人が判断し続けています。「何のために作るか」「何を捨ててよいか」をAIに任せると、前の章の失敗のように迷走するからです。ここを人が決めておくことで、ほかの工程を安心してAIに任せられます。
Claude CodeとCodexの使い分け
使うモデルは、常に評価し直しています。執筆時点(2026年11月)では、メインがClaude Code(Opus 5.5)、サブがCodex(GPT-6.1 Sol)です。Codexは主に、マルチレビューでの2人目のレビュアーとして使っています。
サブスクリプションの利用枠の残り具合によっては、Codexをメインに切り替えることもあります。どちらがメインになっても回るように、前提を仕様ファイルとしてリポジトリにまとめておくことが大事です。
初心者が最初に1つ選ぶなら、当社はClaude Codeをすすめています。当社が公開しているプラグイン「ff-dev-toolkit」もClaude Code向けで、そのまま試せるためです。
導入の手順5つ
ここまでの経験から、開発チームにAI仕様駆動開発を取り入れるときの手順を5つ挙げます。導入の順番に並べています。
1. 短いMASTER.mdから始める
最初から完璧な仕様をそろえようとすると、止まってしまいます。入口の1枚を作り、必要になったら分けていけば十分です。
2. レビューを複数のAIで自動化する
AIに実装を任せると、人のレビューがすぐにボトルネックになります。同じモデルだけで見ると偏るので、2人目のレビュアーには別のLLMを置きます。
3. 毎月振り返り、レビュアーを見直し続ける
AIへの指示を書くのは人です。視点の違うレビュアーを作り、更新し続けることが品質を決めます。これは、B社さまで毎月KPTを続けた経験から言えることです。
4. 指摘に対応するかの基準を決める
モデルが賢くなるほど細かい指摘が増え、基準がないとレビューが終わらなくなります。当社は、失敗の章でお伝えしたとおりYAGNIを基準にしています。
5. 非エンジニアでも回せる形にする
一部の人しか使えない仕組みでは、チーム全体の生産性は上がりません。当社の非エンジニアのメンバーは、GitHubそのものでつまずきました。「GitHubって何?」というところから、インストール、pull/push/merge(取り込み・送り出し・統合)の意味まで、分からないことばかりでした。
これは当社にとって、とても大きな学びになりました。そこで、それでも開発が進むように、実装を完全に自動で行う仕組みを加えました。さらに、非エンジニアにもっとやさしい入口として「ff-work-toolkit」を作り、公開しています。
まとめ
AIにうまく指示を出すことより、仕様とレビュアーの設計に投資してください。目指すのは、人の介入を減らすことです。ただし仕組みは一度作って終わりではなく、モデルが変わり続けるので、見続けて更新し続ける必要があります。何が大事で何は捨ててよいか(YAGNI)をAIに伝えることも欠かせません。
まずは短いMASTER.md 1枚と、小さな機能1つから始めてみてください。
この記事を書いた人
株式会社フィールフロウ CTO 岡崎太(おかざき ふとし)
AI仕様駆動開発を考案し、2025年4月設立の株式会社フィールフロウで、AI技術開発、AI伴走コンサルティング、FeelFlow AIプロダクト、AI受託開発を手がける。会社として『AI仕様駆動開発 公式ガイド』(Kindle)を出版している。