Codexで429 Too Many Requestsが出る原因|使用量が残っていても出る
 AIエージェントナビ編集部
Codexで作業中に次の表示が出て止まったら、OpenAIのサーバーが「今は受け付けられない」と返し、Codexが自動のやり直しを続けても通らなかったという意味です。使用量メーターが6〜9割残っていても出る報告が多く、プランの使用上限とは別の表示です。本記事では、2026年にGitHubの公式リポジトリへ寄せられた報告とOpenAI担当者の回答をもとに、自分の429がどれに当たるかの切り分けと対処を解説します。
exceeded retry limit, last status: 429 Too Many Requests⚠️ まずCodex全体の障害かを確認(急ぎの方はこちら)
429はOpenAI側の障害や混雑と重なって一斉に出ることがあります。自分の設定を疑う前に、いま障害が起きていないかを確認しましょう。
Codexの「429 Too Many Requests」とは
画面に出る表示
表示はデスクトップアプリ・CLI(ターミナル版)のどちらでも同じ文言です。CLIでは先頭に「ERROR:」、末尾に「request id:」と英数字の識別番号が付きます。識別番号は毎回違う値で、OpenAIへ報告するときに使います。
2026年10月には、Windows・macOS・Linuxのいずれからも、ProとBusinessのプランで同じ表示の報告が上がっています。特定のOSだけで出る表示ではありません。
「exceeded retry limit」は自動のやり直しを使い切った合図
表示の前半「exceeded retry limit」は「やり直しの上限を超えた」、後半「last status: 429」は「最後に返ってきた応答が429だった」という意味です。Codexは送信に失敗すると自動で何度か送り直しており、この表示はそれでも通らなかったときに初めて出ます。
表示が出た時点で、すでに数回分のやり直しが済んでいます。すぐに送り直しても、同じ制限に当たる可能性が高い状態です。
使用上限(usage limit)とは別のもの
OpenAIの公式フォーラムでは、2026年6月に「Codex 429 Too Many Requests」という相談が立ち、OpenAIのサポート担当が次のように回答しています。
A 429 "Too Many Requests" error usually means you've hit a rate limit, either by sending too many requests in a short period or exceeding your current usage limits.(訳)429「Too Many Requests」エラーは通常、短時間に多くのリクエストを送ったか、現在の使用上限を超えたことによる回数制限を意味します。
公式の説明では、原因は「短時間の送りすぎ」と「使用上限」の2つです。ただし、Codexで使用上限に達したときは、通常「You've hit your usage limit」という別の表示になります。
GitHubには、使用量が大きく残っているのに429が出たという報告が2026年だけで十数件あります。まず残量を見て、使用上限かどうかを最初に外すのが近道です。
2026年に起きた429の実例
1月:使用量が残っているのに出た(公式が修正)
2026年1月13日、Proプランの利用者から「5時間枠が約61%残っているのに429が出る」という報告が上がりました。ほかにも「5時間枠96%・週次95%残り」で同じ表示になった人が相次ぎ、症状は約15分続いたと書かれています。
報告者のログには、サーバーが返した次の文が残っています。60秒後に再試行するよう求める、短時間の回数制限の応答です。
You've exceeded the rate limit, please slow down and try again after 60.616292 seconds.OpenAIの担当者は「this is a service-side issue(サービス側の問題)」と答え、同日中に「根本原因に対処した」としてクローズしました。2月に同じ表示の再発報告が来た際は、「似た症状なら別の原因なので、/feedbackでログを送って新しく報告してほしい」と回答しています。同じ表示でも、原因はその都度違うということです。
6月:OpenAI側の障害で一斉に出た
2026年6月3日には、デスクトップアプリでどのチャットに送信しても429になる報告が出て、コメントが40件集まりました。OpenAIの担当者は障害が起きていると認め、次のように書いています。
This is not a client-side issue.(訳)これは利用者側の問題ではありません。
担当者は公式の稼働状況ページにも障害を掲載し、同日のうちに「緩和された」として閉じています。429は、利用者の使い方と無関係にOpenAI側の障害として出ることもあるわけです。
10月:Sol系モデルで報告が続いている(未解決)
2026年10月11日ごろからは、GPT-6.1 SolやGPT-5.6 Solを使う人を中心に429の報告が続いています。「週次の使用量メーターが57%の状態で3本目のチャットを始めると出る」「使用量が99〜100%残っているのにどのモデルでも出る」といった内容で、10月23日時点でいずれも未解決です。OpenAIからの説明はまだありません。
10月21日のCLIの報告には、429と一緒にサーバーが返した次の文が記録されています。報告者によると、約150秒後の再試行を求める指示が付いており、同じ時間にGPT-5.6 Terraへの送信は成功していました。
Codex is at capacity, please try again later(訳)Codexは現在混み合っています。時間をおいて再度お試しください。
OpenAIの公式稼働状況でも、10月13日・14日・21日にCodexの性能低下が記録されています。ただし、記録には429という言葉は出てこないため、429との関係は確定していません。
自分の429を切り分ける3つの確認
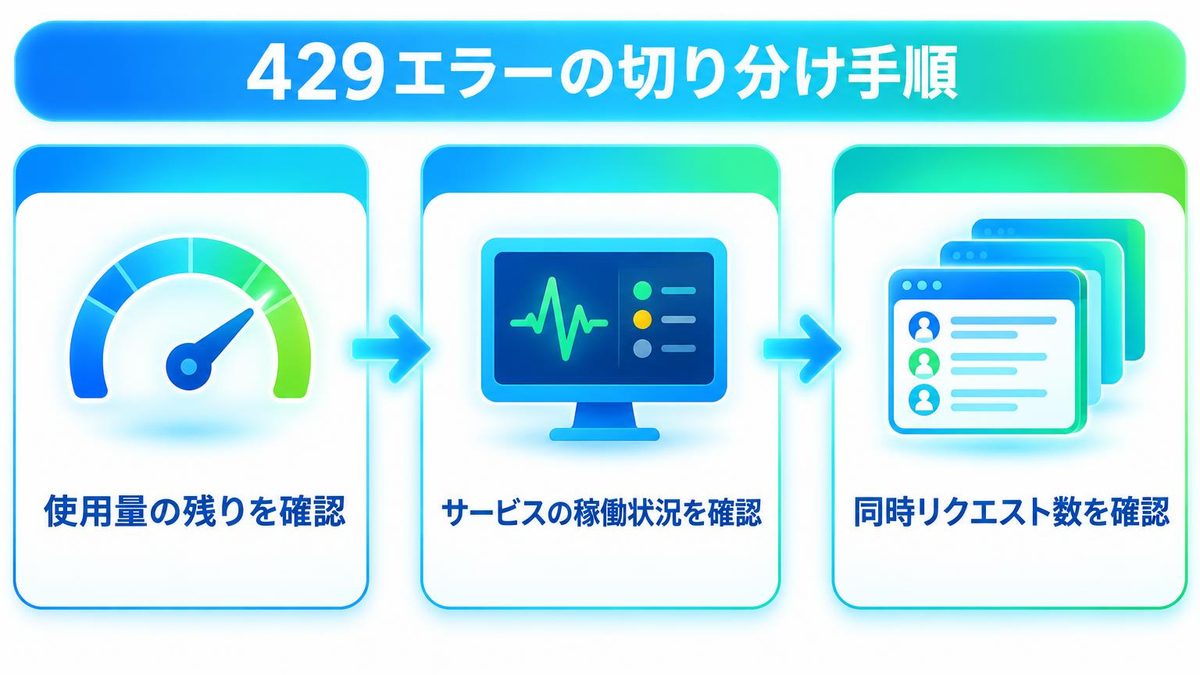
使用量の残りを/statusと使用量画面で見る
最初に、プランの使用量が残っているかを確かめます。CLIなら作業中に「/status」と打つと、残りの使用量と回数制限の状況が表示されます。アプリの場合は、ChatGPTの設定にあるCodexの使用量画面(chatgpt.com/codex/settings/usage)で確認できます。
Codexの公式料金ページによると、PlusとBusiness(標準)は5時間ごとの枠に加えて週ごとの枠がかかることがあり、Proは現在5時間枠がありません。残りが0に近ければ使用上限の問題、十分に残っていれば429の問題として次の確認へ進みます。
稼働状況で障害が出ていないか見る
次に、OpenAI側で障害や性能低下が起きていないかを確かめます。Codex稼働状況ページで、直近の記録を見てください。
障害が記録されていれば、6月の例のように復旧を待つのが一番の近道です。
同時に動かしているチャットとサブエージェントを数える
障害が出ていないのに自分だけ止まるときは、同時にいくつ動かしているかを数えます。10月には「2本は動くのに3本目で429になる」「3セッションだけで残り69%なのに出る」という報告があります。
サブエージェント(Codexが作業を分担させるために立ち上げる子のエージェント)も、それぞれがサーバーへ送信します。親1本の作業でも、裏では複数が同時に動いていることがあります。
429が出たときの対処
手順1:連打せず数分待つ
表示が出たら、まず送信を止めて数分待ちます。前述の公式フォーラムでも、OpenAIのサポート担当は「Repeated retries can actually extend the problem(再試行を繰り返すと、かえって問題が長引くことがある)」と書いています。
1月の例では約60秒後、10月の例では約150秒後の再試行が求められていました。少なくとも2〜3分は空けてから、同じ指示をもう一度送ってください。
手順2:別のモデル・推論レベルに切り替える
待っても直らないときは、モデルを替えてみます。10月の報告には、GPT-5.6 Solで429が続く間もGPT-5.6 TerraやGPT-6 Lunaでは動いたという例があります。一方で、GPT-6 Lunaでも一部の送信が429になったという声もあり、替えれば必ず動くわけではありません。
推論レベル(考える深さの設定)で結果が変わったという報告もあります。GPT-5.6 Solを「Light」にすると毎回429になり、「Medium」に上げると動いたという例です。ただし同じ報告には「Mediumでも出るようになった」という追記もあります。いずれも利用者の報告ベースの回避策で、公式に案内された対処ではありません。
手順3:同時に動かす数を減らす
複数のチャットを並行して走らせているなら、1〜2本に絞ります。サブエージェントを多く使う作業では、同時に立ち上がる数を減らすのも手です。
Codexのサブエージェントの公式ドキュメントでは、設定ファイル(config.toml)の「agents.max_concurrent_threads_per_session」で、1つのセッションで同時に開くサブエージェントの数に上限をかけられるとしています。この設定で429が必ず消えるわけではありませんが、同時に動く数を確実に減らせます。
手順4:直らなければ/feedbackで報告する
どのモデルでも、1本だけで動かしても429が続くなら、アカウントや地域に固有の問題かもしれません。Codexで「/feedback」と打つと、ログと作業の情報をOpenAIへ送れます。
GitHubの公式リポジトリで報告する場合は、/feedbackのあとに表示されるスレッドIDと、エラー表示のrequest idを添えると調べてもらいやすくなります。
似ている表示との見分け方
作業が止まる表示は429だけではなく、文言でとるべき行動が変わります。
| 表示 | 意味 | まず取る行動 |
|---|---|---|
| exceeded retry limit, last status: 429 Too Many Requests | 自動のやり直しでも通らなかった(回数制限・混雑・障害) | 数分待つ・モデルを替える・同時実行を減らす |
| Selected model is at capacity | 選んだモデルが混み合っている | 時間をおく・別のモデルを選ぶ |
| You've hit your usage limit | プランの使用量を使い切った | リセットを待つ・クレジットを買い足す |
| APIキー利用時の429 | 回数制限のほか、残高切れ・支出上限のこともある | エラーの種類を見て残高・上限を確認する |
「Selected model is at capacity」
「選んだモデルは混み合っています。別のモデルを試してください」という意味の表示で、OpenAI側の混雑で出ます。10月の報告では、429とこの表示が同じ時期に交互に出ている例もあります。どちらも、モデルを替えると動くことがある点は共通です。
関連記事:Codexで「Selected model is at capacity」と出る原因と対処
「You've hit your usage limit」
プランの使用量を使い切ったときの表示で、429と違って数分待っても直りません。5時間枠や週次枠のリセットを待つか、PlusとProはChatGPTのクレジットを買い足すと作業を続けられます。
関連記事:Codexの使用上限がリセットされる時間と確認方法
APIキーで使っているときの429
ChatGPTのアカウントでなくAPIキーでCodexを使っている場合、429の意味は1つではありません。OpenAIのAPIエラーコード一覧では、429を「送るのが速すぎる」「前払いの残高切れ」「組織やプロジェクトの支出上限」などに分けています。
残高切れ(credit_balance_exhausted)や支出上限の429は、待っても直りません。エラーの詳細に出る種類を見て、残高の追加や上限の見直しをしてください。
まとめ
Codexの「429 Too Many Requests」は、自動のやり直しでもサーバーに受け付けてもらえなかったという表示で、使用量が残っていても出ます。2026年は1月に不具合、6月に障害、10月にSol系モデルでの報告の集中と、OpenAI側が原因だった例が目立ちます。
表示が出たら、/statusで残量を、稼働状況ページで障害を確かめます。どちらも問題なければ、2〜3分待つ、モデルを替える、同時に動かす数を減らすの順に試し、続くときは/feedbackで報告しましょう。